Jev, le modèle IA qui décide au lieu de parler : System One, MCP et Spring AI
Faut-il vraiment un LLM pour répondre « oui » ou « non » ? Retour sur notre présentation interne consacrée à Jev, le premier modèle « System One » de TypeSafe AI : son fonctionnement, ses garanties, son prix, et deux cas d'usage concrets avec un serveur MCP Spring AI et jev-router.

🤔 Et si votre IA parlait moins et décidait plus ?
Lors de notre dernier mercredi technique, nous avons ouvert la session sur quatre situations que rencontrent la plupart des équipes qui intègrent l’IA dans leurs applications :
- Faire appel à un LLM pour une réponse binaire ? « Ce mail est-il un spam ? », « Ce ticket est-il urgent ? », « Cet avis client est-il positif ? » : autant de questions simples, traitées par des modèles conçus pour rédiger et générer du texte.
- Payer cher une réponse toute simple ? Des milliers de tokens consommés… pour une réponse d’un seul mot.
- Un LLM qui affirme quelque chose de faux ? Une catégorie inventée, une source imaginaire, une réponse fausse mais assurée.
- Coder en
if / elsedes décisions qui demandent du jugement ? Les règles s’empilent, deviennent fragiles et ne couvrent jamais tous les cas.
Si l’une de ces situations vous parle, vous n’êtes pas seuls. C’est précisément le problème auquel s’attaque Jev, le modèle lancé par TypeSafe AI le 15 septembre 2026 : non pas générer du texte, mais prendre des décisions.
⚡ Aux origines du nom : le paradoxe de Jevons
Jev tire son nom de William Stanley Jevons, économiste anglais qui formulait en 1865 son célèbre paradoxe : plus une ressource devient abondante et bon marché, plus son usage se généralise.
L’ambition de TypeSafe AI est claire : avec un coût annoncé 100 à 500 fois inférieur à celui d’un LLM, faire de la décision IA une ressource omniprésente, intégrée au cœur des systèmes numériques. Là où les modèles génératifs incarnent une réflexion lente et verbale, Jev agit comme un moteur de décision plutôt qu’un outil de conversation. Ce n’est pas une IA qui parle aux humains, mais une IA qui aide les machines à décider.
Source : TypeSafe AI. Chiffres non vérifiés de façon indépendante.
🧠 Jev, un modèle « System One »
À l’origine de Jev, il y a un livre : Thinking, Fast and Slow, dans lequel Daniel Kahneman décrit nos deux systèmes de pensée. Psychologue et prix Nobel d’économie en 2002, il y montre que notre cerveau fonctionne à deux vitesses.
Le Système 1 est rapide, intuitif et automatique : c’est lui qui nous fait reconnaître un visage familier ou freiner devant un obstacle, sans y penser. Le Système 2 est lent, réfléchi et exigeant : nous le mobilisons pour résoudre un calcul, peser le pour et le contre ou construire un raisonnement. La plupart de nos décisions quotidiennes relèvent du premier ; le second n’intervient que lorsque la situation l’exige.
Transposée à l’IA, cette distinction éclaire un paradoxe. Les LLM, conçus pour raisonner et rédiger, jouent le rôle du Système 2… y compris pour des questions qui ne demandent qu’un réflexe. Jev prend le parti inverse : devenir le Système 1 de l’IA, celui qui tranche vite, à moindre coût, et laisse la réflexion approfondie aux modèles faits pour cela.
| Système 1 · rapide | Système 2 · lent | |
|---|---|---|
| Pensée | Rapide et automatique | Réflexion approfondie, effort conscient |
| Chez l’humain | Reconnaître la colère sur un visage | Calculer 17 × 24 de tête |
| En IA | Jev (TypeSafe AI), Laya (ConvAI, open source) | Claude, ChatGPT, Gemini, Mistral |
Jev porte des jugements instantanés et renvoie ses décisions sous trois formes typées :
choice: un choix parmi une liste d’options (jusqu’à 255) ;score: une note sur une échelle ordinale ;noul: une probabilité entre 0 et 1.
La souplesse d’un LLM, la vitesse d’un classifieur
Prenons la tâche la plus courante : la classification de texte (un mail, un ticket, un avis client) dans une catégorie. Aujourd’hui, deux options s’offrent aux équipes, et Jev se place entre les deux.
| Classifieur entraîné | LLM généraliste | Jev | |
|---|---|---|---|
| précis, mais rigide | souple, mais lent et coûteux | le meilleur des deux | |
| Vitesse (temps de réponse) | ▰▰▰▰▰ | ▰▰▰▰▰ | ▰▰▰▰▰ |
| Coût réduit (prix par décision) | ▰▰▰▰▰ | ▰▰▰▰▰ | ▰▰▰▰▰ |
| Souplesse (nouvelles catégories sans ré-entraînement) | ▰▰▰▰▰ | ▰▰▰▰▰ | ▰▰▰▰▰ |
| Précision (taux de bonnes réponses) | ▰▰▰▰▰ | ▰▰▰▰▰ | ▰▰▰▰▰ |
| À retenir | Données étiquetées et ré-entraînement | Plusieurs secondes, sortie à parser | On décrit les options, Jev décide |
Appréciation qualitative, pour une tâche de classification de texte.
Jev prend l’avantage quand on n’a pas de données étiquetées, quand les catégories changent souvent, ou quand on veut poser plusieurs questions en un seul appel.
Nuance importante : quand les catégories sont fixes et les données étiquetées disponibles, un classifieur entraîné reste souvent plus précis. Dans un benchmark, un encodeur associé à une régression logistique devance Jev sur 3 jeux de données sur 4 (Banking77, emotion, phishing).
Pour les équipes tech comme pour les métiers, c’est un vrai gain : Jev fonctionne en zero-shot, sans exemple ni entraînement. On décrit les options, Jev décide.
⚖️ Jev vs Laya : la vraie question, c’est l’ownership
Jev n’est pas le seul modèle System One. Laya, de ConvAI, répond au même besoin, mais fait un autre choix : l’open source.
| Jev · TypeSafe AI | Laya · ConvAI | |
|---|---|---|
| Positionnement | Solution hébergée, propriétaire | Modèle ouvert (ModernBERT-large, 421M paramètres) |
| Distribution | API uniquement, pas d’exécution locale | Téléchargeable sur Hugging Face, Apache 2.0 |
| Précision sans fine-tuning* | 0,9065 | 0,6863 |
| Fine-tuning | Pas de workflow public | Précision ×2 (0,36 → 0,77, benchmark interne) |
| Cardinalité | Jusqu’à 255 options | Se dégrade sur haute cardinalité |
| Coût | 0,042 $/M tokens en entrée, sortie gratuite | Pas de licence, mais infra et ops à votre charge (GPU, autoscaling, observabilité…) |
* sysone-bench, benchmark open source (licence MIT) publié par un développeur indépendant, 1 240 décisions.
Jev s’impose quand on veut livrer vite : rien à héberger, des décisions solides out-of-the-box, un grand espace de choix. Laya s’impose quand les décisions sont répétitives et spécifiques à un domaine : on-premise, poids locaux, fine-tuning possible.
🔁 Un état, des questions, des décisions typées
Le fonctionnement de Jev tient en trois éléments : un état (le contenu à juger), des questions et des décisions typées en sortie.
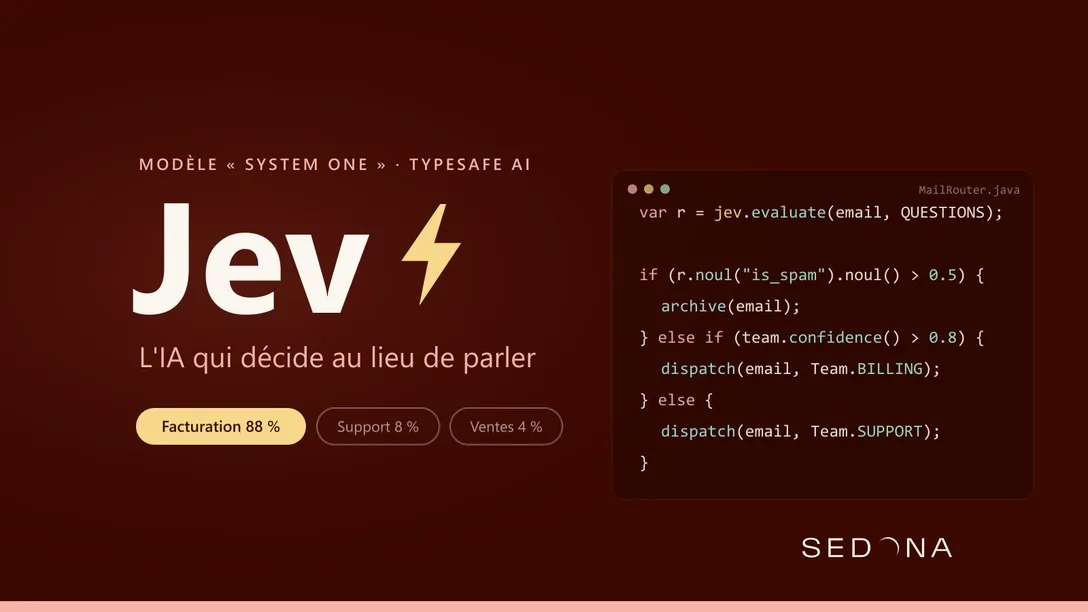
Prenons un mail client : « Bonjour, j’ai été débité deux fois pour ma commande. Je suis vraiment agacé. Puis-je être remboursé ? ». En un seul appel à POST /v1/systemone, on pose trois questions :
is_spam(probabilité) → 0,03 : ce n’est pas un spam ;team(choix parmi Facturation, Support, Ventes, Fraude) → Facturation, avec 88 % de confiance ;tone(score de 0 « calme » à 2 « en colère ») → 1,2 : le client est agacé.
Le code applicatif lit directement la décision et agit :
/* Exemple en langage backend Java: routage d'un mail client en utilisant Jev */

@Service
public class MailRouter {

    private final JevClient jev;

    public MailRouter(JevClient jev) {
        this.jev = jev;
    }

    public void route(Email email) {

        // QUESTIONS : une Map qui contient vos questions et leurs options
        JevResponse response = jev.evaluate(email.body(), QUESTIONS);

        double spamProbability = response.noul("is_spam").noul();
        Answer.Choice team     = response.choice("team");

        if (spamProbability > 0.5) {
            archive(email);
        } else if ("BILLING".equals(team.choice()) && team.confidence() > 0.8) {
            dispatch(email, Team.BILLING);    // 88 % > 80 % : routage automatique
        } else {
            dispatch(email, Team.SUPPORT);    // sinon, le support relit
        }
    }
}
🛡️ Ce que garantit Jev : le format, pas la justesse
TypeSafe AI affirme que Jev « can’t hallucinate ». Il faut bien comprendre ce que cela signifie.
✅ Garanti : le format. Jev ne peut répondre qu’avec une option fournie. Si la liste contient Facturation, Support, Ventes et Fraude, il ne répondra jamais « Comptabilité ».
❌ Pas garanti : la justesse. Sur le mail de double débit, Jev peut très bien répondre « Support » avec 58 % de confiance : la réponse est valide (elle est dans la liste)… mais fausse.
Comme le résume Armin Ronacher (créateur de Flask, CTO d’Earendil), cité par TechCrunch le 18 septembre 2026 : « Jev délègue le problème de l’hallucination à l’utilisateur. » Le modèle donne le chiffre, c’est à vous de décider à partir de quand agir.
D’où l’importance des seuils, à fixer par cas d’usage avec le métier. Par exemple :
- p ≥ 0,9 : Jev décide seul, action automatique ;
- 0,6 ≤ p < 0,9 : on escalade vers un LLM, plus lent mais qui raisonne ;
- p < 0,6 : un humain tranche.
Un seuil à 0,5 reviendrait à jouer à pile ou face : le « Support » à 58 % passerait en automatique.
🎯 RLHF vs RLCD : pourquoi la confiance de Jev est fiable
Un seuil n’a de sens que si la confiance annoncée est fiable. C’est tout l’enjeu de la méthode d’entraînement de Jev, le RLCD (Reinforcement Learning for Calibrated Decisions), qui se distingue du RLHF (Reinforcement Learning from Human Feedback) qui a fait le succès des assistants conversationnels.
| RLHF · Claude, ChatGPT | RLCD · Jev | |
|---|---|---|
| Le modèle est récompensé quand… | sa réponse plaît à l’humain qui la lit | il estime honnêtement sa propre certitude |
| Résultat | un texte fluide et convaincant | une confiance calibrée |
| Ce que vaut « 80 % » | un ton assuré, sans garantie | environ 8 bonnes réponses sur 10 |
« They learn how to produce an answer a person likes reading. That’s a terrible property if you need the model to make important decisions. » — Diogo Almeida, CEO de TypeSafe AI, ex-OpenAI et co-inventeur du RLHF
Et les API « décisionnelles » des LLM, comme Decisions API (GPT-6-Luna) ? Elles imposent un format structuré, mais un format n’est pas un entraînement : rien ne garantit qu’un 0,92 corresponde à 92 % de bonnes réponses.
💶 Le prix : on paie ce qu’on envoie, la décision est offerte
Jev ne génère aucun token de texte : seules les entrées sont facturées.
| Modèle | Entrée / 1M tokens | Sortie / 1M tokens | Écart sur l’entrée |
|---|---|---|---|
| Jev · TypeSafe AI | 0,042 $ | Gratuit | référence |
| Decisions API (GPT-6-Luna) | 0,10 $ | Gratuit | × 2,4 |
| Claude Opus 5.5 | 4 $ | 20 $ | × 95 |
| Claude Fable 5.1 | 10 $ | 50 $ | × 238 |
Tarifs publics officiels, octobre 2026. Attention : Decisions API accepte texte et images, Jev se limite au texte. Et ce sont des produits distincts : Claude rédige, Jev et Decisions API décident.
🛒 Use case 1 : Jev + un serveur MCP avec Spring AI
Pour illustrer, nous avons construit un assistant pour une marketplace fictive. Le client demande : « Où en est ma commande 12345 ? »
Notre backend Spring AI joue le rôle de chef d’orchestre et appelle tour à tour Jev, le serveur MCP et un LLM :
- Jev choisit le tool à utiliser parmi
searchProducts,getOrderStatus,getCustomerProfile,cancelOrder,refundOrderounone→getOrderStatus, confiance 0,94, en ~200 ms. - Le backend vérifie que le tool n’est pas
noneet que la confiance est ≥ 0,6. Sinon, le LLM prend directement la main. - Le tool est appelé sur le serveur MCP, qui lit la base des commandes.
- Le LLM rédige la réponse (1 à 5 s) à partir du résultat, avec la consigne de n’inventer rien qui ne figure pas dans le résultat du tool.
Au fond, la question n’est pas de choisir l’un ou l’autre, mais de confier à chacun ce qu’il fait de mieux. Une décision ne mérite pas un paragraphe : les LLM génèrent, Jev décide.
MCP : un tool écrit une fois, utilisable partout
Rappel (voir aussi notre article MCP Kezako ?) : le Model Context Protocol standardise la façon dont un client IA découvre et appelle des outils.
- Un tool, tous les clients : Claude Code, Cursor, VS Code ou Spring AI, quel que soit le LLM derrière. Fini les versions par modèle.
- Un format de message : tout le monde parle JSON-RPC 2.0.
- Une connexion standard : stdio en local, Streamable HTTP en réseau.
- Découverte automatique : via
tools/list, le serveur annonce ses tools.
Avec Spring AI, il suffit d’annoter une méthode avec @McpTool pour dire au framework : « ceci, une IA peut l’utiliser ».
@Component
public class OrderTools {

    private final OrderService orderService;

    public OrderTools(OrderService orderService) {
        this.orderService = orderService;
    }

    @McpTool(name = "getOrderStatus",
             description = "Statut et date de livraison d'une commande")
    public OrderStatus getOrderStatus(
            @McpToolParam(description = "Numéro de commande, ex. 12345")
            String orderId) {
        return orderService.findOrderStatus(orderId);
    }
}
Côté dépendances, on ajoute spring-boot-starter-web et spring-ai-starter-mcp-server-webmvc, puis on configure le serveur :
spring:
  ai:
    mcp:
      server:
        name: marketplace-mcp
        version: 1.0.0
        protocol: streamable
        stdio: false
        type: sync
Pour tester, le MCP Inspector se lance avec npx @modelcontextprotocol/inspector.
Brancher Claude Code sur le serveur MCP
Un fichier .mcp.json à la racine du projet, partagé avec l’équipe via Git, suffit :
{
    "mcpServers": {
      "marketplace-mcp": {
        "command": "java",
        "args": ["-jar", "target/marketplace-mcp-1.0.0.jar", "--spring.profiles.active=stdio"]
      }
    }
  }
Claude Code lance le jar et lui parle en stdio. Au premier lancement de claude, on approuve le serveur (la commande /mcp permet de vérifier). Il ne reste qu’à demander « Où en est ma commande 12345 ? » : Claude Code appelle getOrderStatus et répond que la commande a été expédiée, avec une livraison prévue le 10 janvier 2027.
🔀 Use case 2 : jev-router, Jev choisit le modèle à chaque prompt
Deuxième cas d’usage, open source cette fois : jev-router. Il s’ajoute à la liste des modèles de votre CLI de dev (ici Claude Code) et, à chaque prompt, c’est Jev qui choisit entre Haiku (rapide, peu cher), Sonnet (bon rapport qualité/prix) et Opus (cher, lent, puissant).
Sous le capot, chaque prompt déclenche une requête à Jev avec :
- un état : la demande du développeur, le modèle actuel, la taille du contexte et les modèles disponibles ;
- des questions : quel modèle choisir (
choice), et trois scores sur 10 niveaux (complexité de la tâche, besoin de raisonnement, complexité des outils).
$ claude
> /model

  Choisir un modèle
    Opus      puissant, mais cher et lent
    Sonnet    bon rapport qualité/prix
    Haiku     rapide et économique
  ❯ jev-router   Jev choisit le modèle à chaque message

> renomme arr en users (prompt #1)
  ⚡ jev-router ─▶ Haiku     confiance 0,92 · tâche simple

> refactor cette classe avec le pattern Observer (prompt #2)
  ⚡ jev-router ─▶ Opus      tâche complexe · raisonnement requis

> ajoute des tests unitaires sur OrderService (prompt #3)
  ⚡ jev-router ─▶ Sonnet    complexité moyenne
Résultat : fini le choix de modèle au démarrage, on ne paie Opus que quand c’est vraiment utile.
La présentation s’est conclue sur une démo vidéo de jev-ultrafast (Browser Use × TypeSafe), un agent qui pilote le navigateur et où Jev joue le rôle du « cerveau qui clique ».
💡 Ce qu’il faut retenir
Jev ne remplace pas les LLM : il propose une autre approche, pensée pour décider plutôt que pour raisonner et rédiger du texte.
Placé comme couche d’intelligence entre nos applications et nos LLM, il trie, route et choisit rapidement. Le LLM n’intervient plus que lorsqu’il faut vraiment rédiger ou résoudre des tâches complexes. Seule condition : fixer des seuils de confiance avec le métier, et tester sur ses propres données.
L’IA de demain ne reposera plus sur un modèle unique, mais sur le bon modèle pour chaque tâche.
Vous envisagez d’intégrer de la décision IA ou un serveur MCP dans vos applications ? N’hésitez pas à venir échanger avec nous !
Questions fréquentes
Qu'est-ce qu'un modèle « System One » comme Jev ?
C'est un modèle d'IA conçu pour décider, pas pour rédiger. Inspiré du Système 1 de Daniel Kahneman (rapide, intuitif), Jev renvoie un choix parmi des options, une note ou une probabilité, dans un format typé que le code lit directement, en environ 200 ms.
Jev peut-il halluciner ?
Jev garantit le format de sa réponse, pas sa justesse. Il ne peut répondre qu'avec une option fournie, mais il peut se tromper d'option. C'est pourquoi il renvoie un niveau de confiance : c'est à vous de fixer le seuil à partir duquel le système agit seul, escalade vers un LLM ou passe la main à un humain.
Combien coûte Jev par rapport à un LLM ?
Jev est facturé 0,042 $ par million de tokens en entrée, et les décisions en sortie sont gratuites. Selon les tarifs publics d'octobre 2026, c'est 95 à 238 fois moins cher en entrée que les grands modèles généralistes. TypeSafe AI annonce un coût global 100 à 500 fois inférieur, chiffre non vérifié de façon indépendante.
Jev remplace-t-il un LLM ?
Non, il le complète. Jev choisit par exemple quel tool appeler ou quel modèle utiliser, puis un LLM rédige la réponse si nécessaire. Les LLM génèrent, Jev décide : le bon modèle pour chaque tâche.